IA et cybersécurité : pourquoi les données mal maîtrisées deviennent un nouveau risque

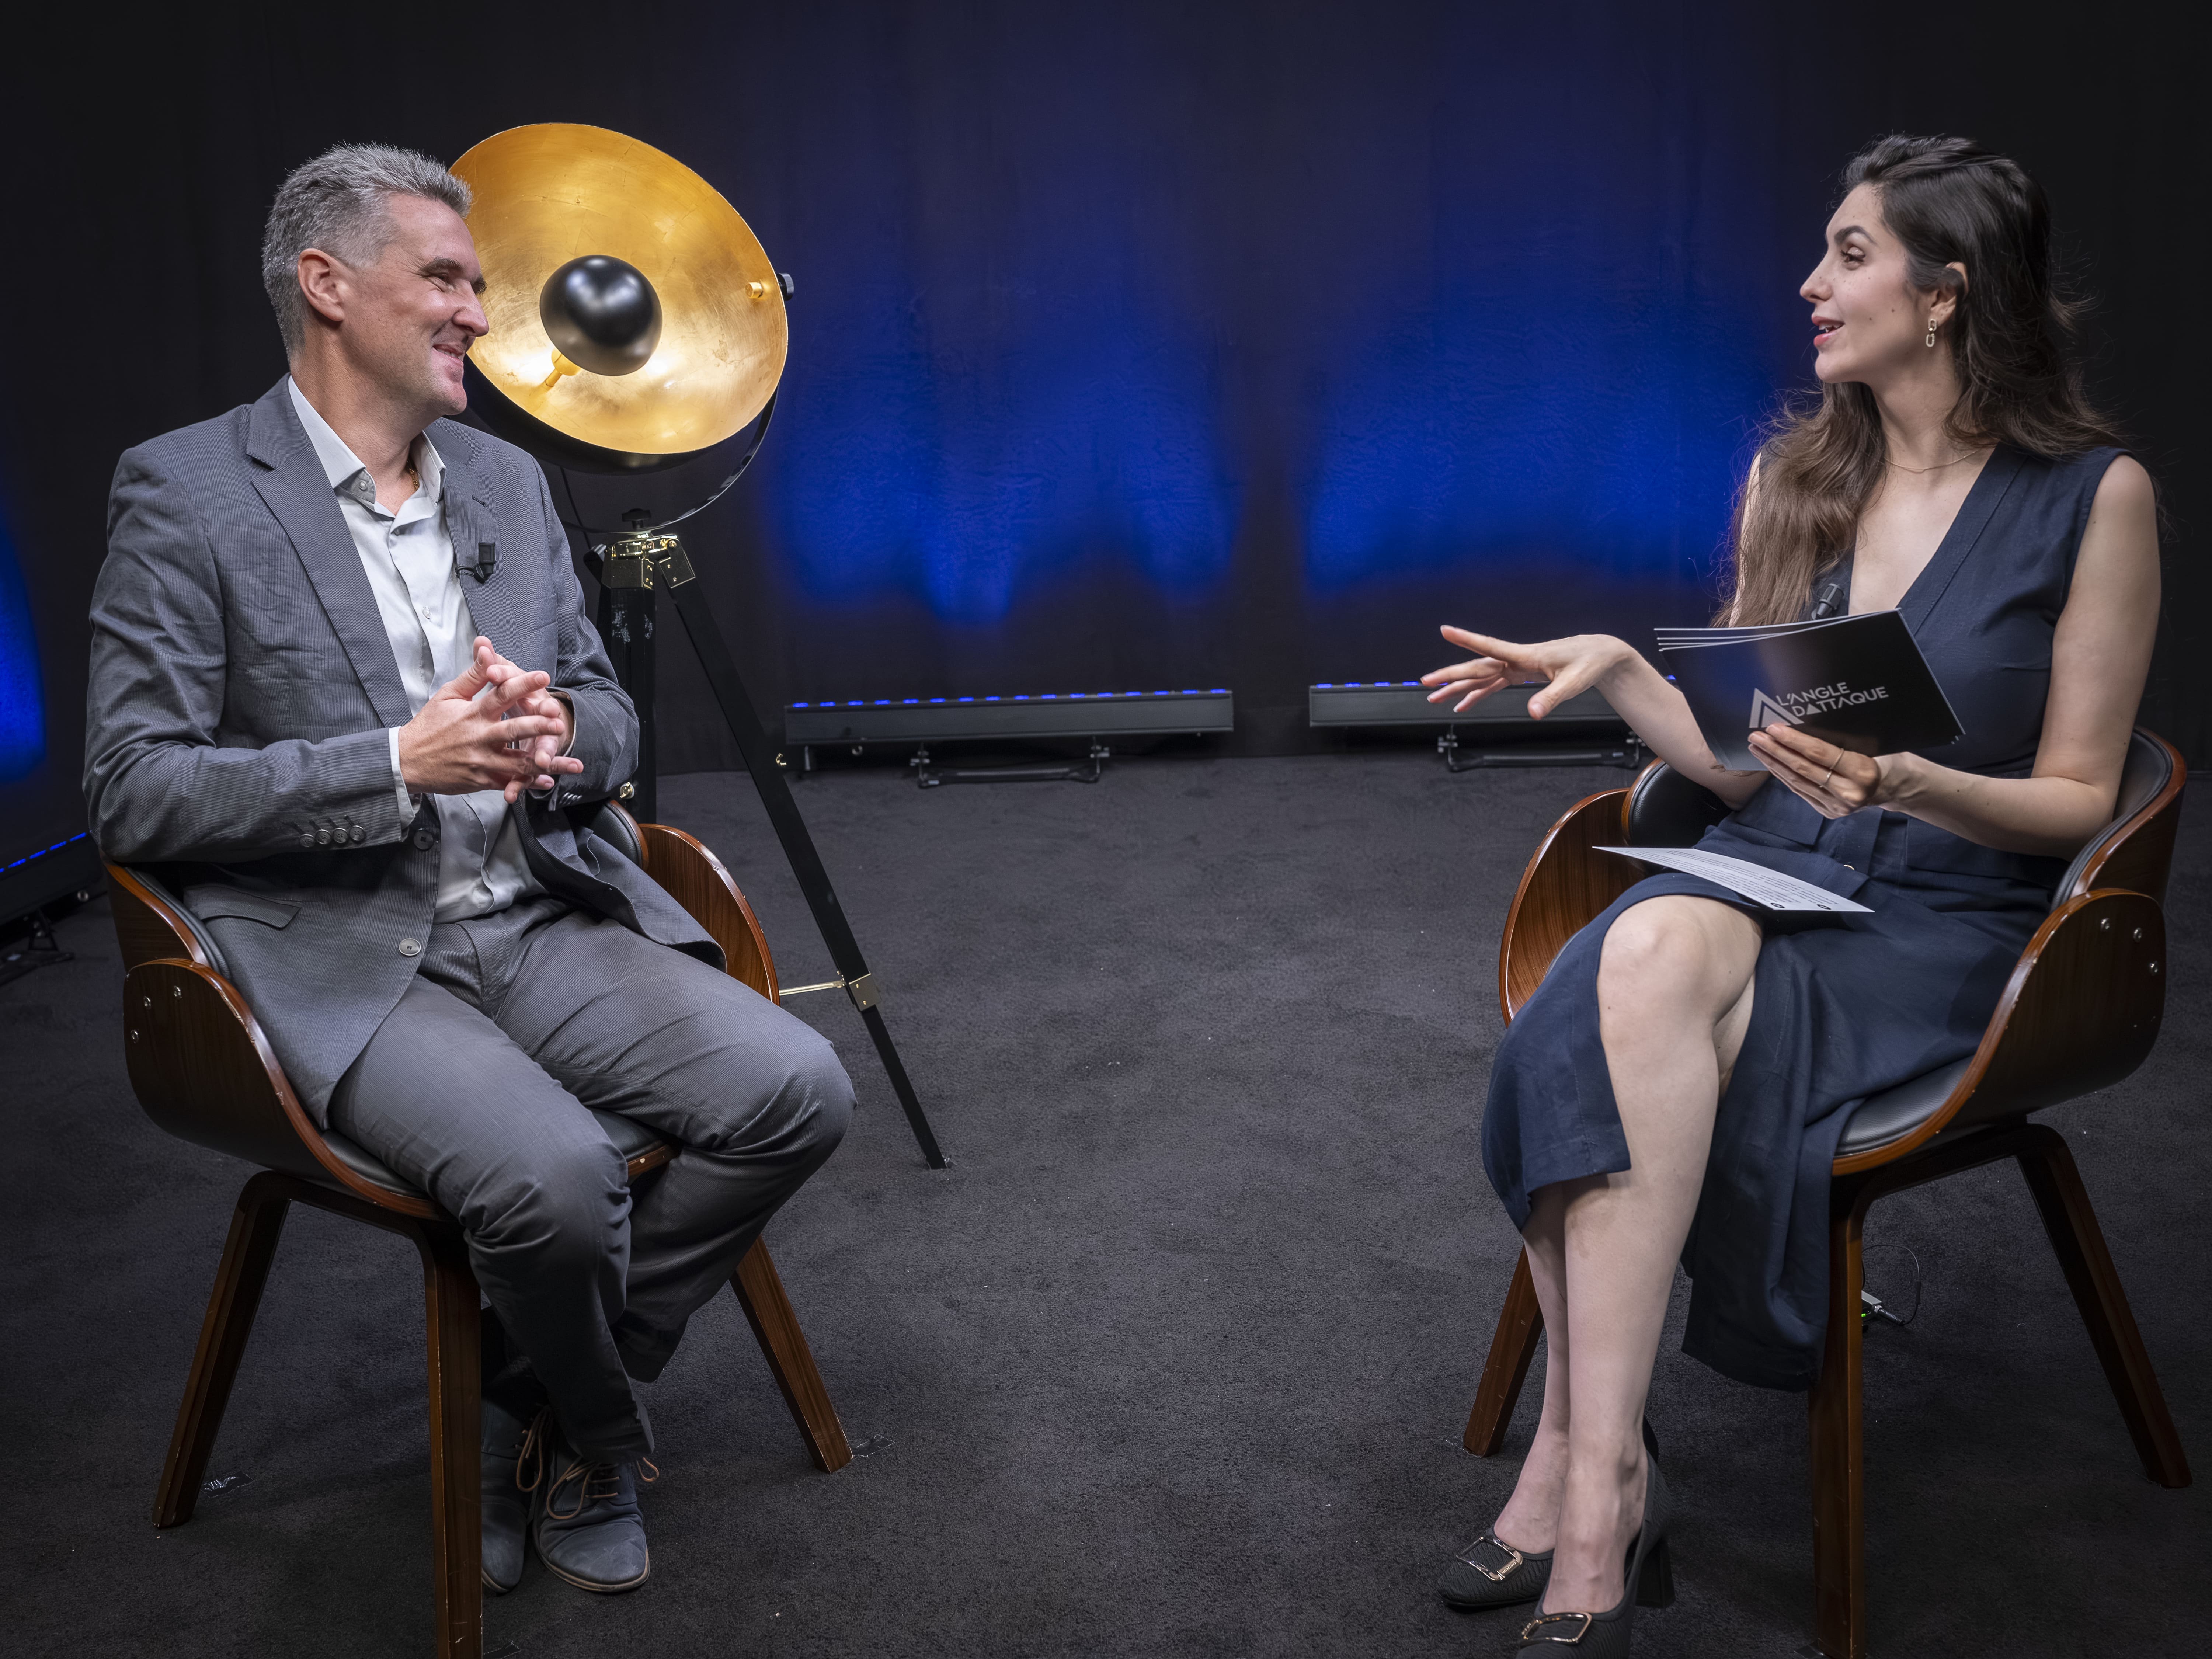
L’IA générative promet de rendre l’information accessible en quelques secondes. Mais lorsque les données d’entreprise sont mal classifiées, dispersées ou peu gouvernées, cette capacité devient aussi un risque. Pour Guillaume Braux, directeur technique chez Box, l’IA ne crée pas nécessairement une nouvelle vulnérabilité : elle peut surtout rendre visibles des informations qui étaient déjà là, mais que l’entreprise ne savait plus identifier ni maîtriser.
Le premier risque de l’IA se cache peut-être dans les données que l’entreprise ignore
Avant même de parler d’intelligence artificielle, il faut parler de données. Et surtout de données non structurées. « 90 % des données qui composent le patrimoine numérique des entreprises sont non structurées », rappelle Guillaume Braux. Des documents qui peuvent se trouver sur un poste de travail, dans un espace de stockage, en pièce jointe d’un e-mail ou encore transférés via un service externe. Le problème tient précisément à cette dispersion. « Ce qui caractérise les données dites non structurées ou documentaires, c’est leur extrême volatilité », explique-t-il. Elles peuvent circuler, être copiées, déplacées et stockées dans des environnements multiples.
À lire aussi : Fuite DGFiP : un seul compte volé, 678 000 personnes exposées
Résultat : « elles peuvent être partout et nulle part ». Pour le directeur technique de Box, le premier enjeu est donc presque élémentaire : savoir ce que l’entreprise possède. « Tout tourne autour de cette thématique de connaître sa donnée. » Car sans cette connaissance, impossible de construire une véritable politique de sécurité. « À partir du moment où je ne sais pas différencier un PDF d’un autre PDF, il m’est impossible de mettre en œuvre aucune forme de règle de gouvernance d’entreprise. » L’arrivée de l’IA change toutefois profondément la donne. Car jusqu’ici, une donnée mal gouvernée pouvait rester relativement invisible.
L’IA supprime une protection aussi vieille que le désordre documentaire : l’ignorance
C’est là que se situe, selon Guillaume Braux, l’un des principaux risques liés à l’IA générative. « Le risque principal de la mise en œuvre de technologie de large model de langage sur de la donnée documentaire, c’est justement [...] de faire remonter à la surface des informations qui étaient noyées jusqu’à présent. » Le paradoxe est important : l’IA ne crée pas forcément l’exposition. Elle peut simplement rendre exploitable une exposition qui existait déjà.
À lire aussi : Gestion des vulnérabilités : l'IA impose de passer de la guerre du patch à la guerre de mouvement
Pendant des années, une entreprise pouvait avoir des informations accessibles sans pour autant qu’elles soient facilement retrouvables. Un document oublié dans un espace partagé, un ancien contrat, un brouillon, une présentation confidentielle : tant que personne ne savait précisément où chercher, le risque restait en partie contenu. Guillaume Braux résume cette situation de manière particulièrement directe : « La sécurité et la protection de ces données était réalisée par une seule et unique chose qui est l’ignorance. Si je ne sais pas que cette donnée existe, je vais pas aller la chercher parce que je ne sais pas qu’elle existe. »
Avec un moteur capable de comprendre une requête en langage naturel, cette barrière disparaît. L’utilisateur n’a plus besoin de connaître le nom du fichier, son emplacement ou l’arborescence dans laquelle il est stocké. Il peut simplement demander ce qu’il cherche. Le problème est alors moins la capacité de l’IA à trouver une information que sa capacité à trouver des informations que l’entreprise n’avait jamais réellement gouvernées.
« Trouve-moi le dernier contrat » : l’IA peut aussi retrouver la mauvaise vérité
Le risque devient encore plus concret lorsqu’on passe de la recherche documentaire à l’usage quotidien de l’IA. Guillaume Braux prend un exemple simple : une entreprise dispose de millions de documents mais n’a pas correctement structuré son patrimoine documentaire. « J’ai 100 millions de documents qui ne sont pas gouvernés. Donc j’ai aucune classification, j’ai aucune metadata, je sais rien. » L’entreprise décide pourtant de brancher une IA sur cette masse documentaire et de permettre aux collaborateurs d’effectuer des recherches en langage naturel.
À lire aussi : Acheter n'est plus posséder, de PlayStation à l'IA
Sur le papier, la promesse est séduisante : « trouve-moi le dernier contrat de telle date, de tel client ». Mais la question essentielle apparaît immédiatement : qu’est-ce qui permet au système de déterminer quel document est réellement le bon ? « Si le fond documentaire, si le fond de l’information n'est pas maîtrisé, qu’est-ce qui différencie le brouillon de la version finale du contrat si c’est pas écrit dedans ? Absolument rien. » L’IA peut donc produire une réponse parfaitement plausible à partir d’une information qui, elle, ne l’est pas.
« Il y a une chance sur deux que ma recherche me remonte une information qui est potentiellement fausse. » Le problème n’est alors pas nécessairement une hallucination du modèle. L’information peut bel et bien exister dans le système. Elle peut même être parfaitement accessible à l’utilisateur. Mais elle peut être ancienne, incomplète, provisoire ou simplement ne pas être la version de référence. C’est pourquoi, pour Guillaume Braux, « la clé, ça reste toujours la maîtrise de la source de la donnée que je fais manger à mon moteur ».
Plus l’IA sait chercher, plus l’entreprise doit savoir ce qu’elle possède
Cette problématique explique aussi pourquoi l’ajout d’un copilote ou d’un moteur de recherche en langage naturel ne suffit pas à régler le problème documentaire. « Tout le monde a voulu accrocher la case, tout le monde a accès à Copilot et finalement on trouve pas plus de choses qu’avant. » Pire : l’utilisateur peut parfois se retrouver avec davantage de résultats à trier parce que l’information disponible n’est pas nécessairement de l’information de confiance. « C’est de la source bureautique, c’est pas de la source de confiance d’entreprise, c’est pas de la source gouvernée et gérée. »
À lire aussi : Fuites de données : former l'humain, dernier rempart cyber
La question de l’IA devient donc indissociable de celle de la gouvernance documentaire. Il ne suffit plus de savoir qui peut accéder à quoi. Il faut également savoir ce qui existe dans cet espace accessible, ce qui fait foi, ce qui est sensible et quelle donnée peut réellement être transmise au modèle. C’est un changement important dans la manière de penser la cybersécurité : l’enjeu ne porte plus uniquement sur les droits d’accès, mais aussi sur la découvrabilité et la fiabilité de l’information.
L’IA ne doit pas devenir une rustine posée sur le chaos
Pour Guillaume Braux, la réponse ne consiste donc pas à renoncer à l’IA, mais à remettre de la gouvernance sous les nouveaux usages. « Si la donnée à la source est bien structurée, je pense que oui. Si en revanche c’est pour maîtriser le chaos, c’est qu’une rustine. » Et cette distinction est essentielle. Une IA peut accélérer considérablement l’accès à l’information. Elle peut aussi automatiser une partie du travail de classification et de compréhension des documents. Mais elle ne peut pas, à elle seule, transformer une masse documentaire mal maîtrisée en référentiel de confiance. À terme, l’architecture doit donc permettre au modèle de ne recevoir que les informations auxquelles il est légitime d’accéder. « Le modèle n’a pas accès à toute la donnée d’entreprise. »
À lire aussi : Panne mondiale d'Internet : le scénario est-il crédible ?
Dans le schéma défendu par Box, c’est la couche de gouvernance qui détermine quelles données peuvent être transmises au modèle : « C’est la couche sous-jacente Box [...] qui va derrière uniquement délivrer au modèle ce qui est pertinent pour réaliser sa mission en fonction du contexte. » Autrement dit, l’IA ne doit pas devenir le nouveau système de contrôle. « Le modèle est juste un exécutant. » La décision de ce qu’il peut consulter doit rester du côté de la gouvernance des données. Car plus les modèles deviennent performants pour retrouver l’information, plus une faiblesse documentaire ancienne peut devenir visible. L’IA ne fait donc pas nécessairement apparaître un nouveau chaos. Elle retire simplement une partie des obstacles qui permettaient jusqu’ici de ne pas le voir.